Dinero
Depende de los puestos premiados, las bases y la comprobación de la entrega.
DEL CÓMIC A LA INGENIERÍA
Del encargo a una solución: datos, modelos, parámetros y decisiones que merece la pena probar. Una guía para leer el cómic con más contexto o empezar a investigar por tu cuenta.
Una organización plantea un problema, fija cómo se puntúa y aporta material para trabajar. Los equipos construyen sus soluciones y presentan una entrega. En unos retos son predicciones; en otros, código que se ejecutará en un entorno controlado. Antes de elegir una red conviene saber qué nos están pidiendo exactamente.
Piensa en un examen para el que podemos estudiar ejemplos resueltos. Necesitamos apartar algunos para comprobar nuestras ideas sin mirar sus respuestas al entrenar. La clasificación añade una comparación externa. En muchos concursos hay puntuación pública y otra reservada para el final: perseguir cada décima de la primera puede hacernos elegir una solución que funcione peor en la segunda.
Para empezar, escogería un reto formativo, reproduciría una solución sencilla y cambiaría una sola decisión. Esa primera entrega enseña el recorrido completo: leer datos, aprender, predecir y producir el archivo correcto. La complejidad ya llegará cuando sepamos qué falla.
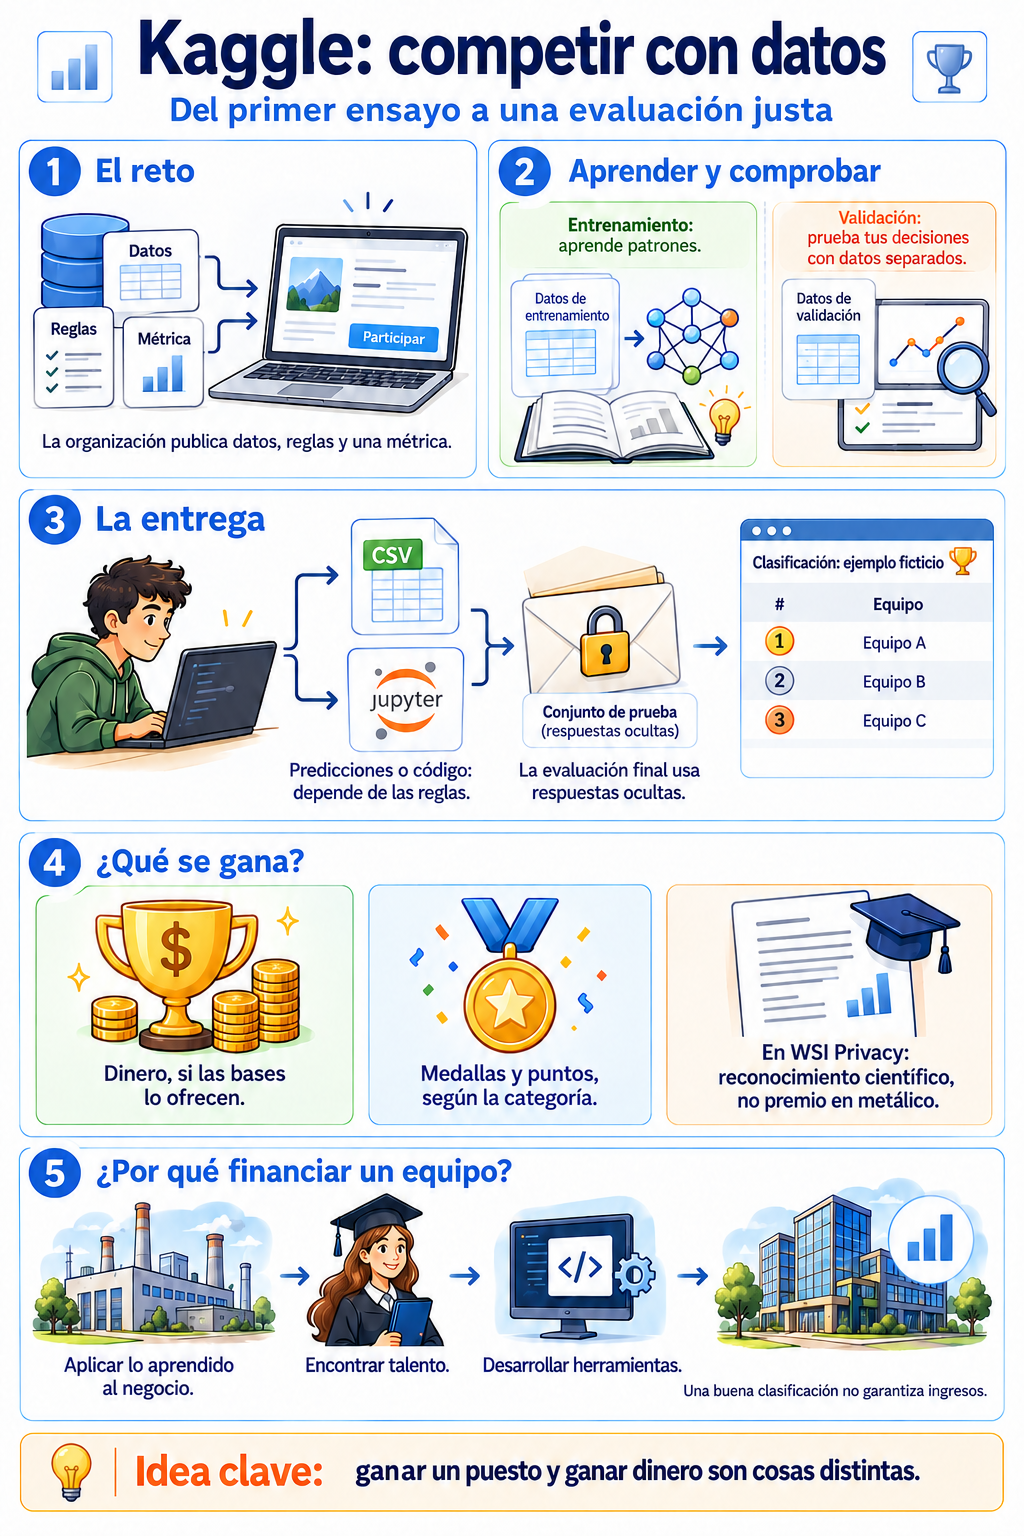
La clasificación es un ejemplo ficticio. Los premios dependen de las bases de cada concurso.
Ampliar y leer la infografía ↗La organización publica datos, reglas y una métrica. El equipo entrena con unos datos y prueba sus decisiones en una validación separada.
Según las reglas, se entregan predicciones o código. La evaluación final utiliza respuestas ocultas. La clasificación dibujada es ficticia.
Puede haber dinero si las bases lo ofrecen; medallas y puntos dependen de la categoría. WSI Privacy ofrece reconocimiento científico, no un premio en metálico. Una empresa puede financiar aprendizaje aplicable, herramientas y talento: una buena clasificación no garantiza ingresos.
Objetivo, reglas y entrega
Un resultado que podamos repetir
Con ejemplos apartados
Según el formato del reto
Hay que leer las bases. Si reparten dinero entre tres puestos, el segundo también puede cobrar. Si solo premian al primero, el segundo no tiene un premio en metálico por el mero hecho de quedar cerca. Un buen puesto tampoco convierte la participación en un sueldo.
Conviene separar tres cosas que suelen mezclarse al hablar de Kaggle: dinero, reconocimiento dentro de la plataforma y reconocimiento científico. El organizador establece qué ofrece y qué condiciones exige. Las medallas no son dinero ni todos los concursos las conceden.
En WSI Privacy se anuncia reconocimiento científico: invitación a una publicación conjunta para equipos destacados y certificados. No se anuncia premio en metálico. La financiación de ATLAS pertenece a la ficción.
Depende de los puestos premiados, las bases y la comprobación de la entrega.
Reconocen resultados en competiciones que los conceden. No son un pago.
Una publicación, un método útil o una colaboración pueden ser el objetivo.
Benchmarking WSI Privacy, Track 1 pide seleccionar, entre 100 candidatas, las imágenes del mismo paciente que una consulta, usando contenido visual. Puede haber ninguna, una o varias. Se entrega un CSV y se puntúa con F1 medio por consulta.
Imagina dos archivos con nombres retirados. Si una imagen permite enlazarlos, podría reunir información que se creía separada. Este ejercicio estudia ese vínculo. No consiste en diagnosticar una enfermedad ni en obtener el nombre de una persona.
El siguiente dibujo representa la pregunta. Una imagen parecida puede ser una falsa coincidencia; hace falta aprender qué parecido resulta útil. Track 2 plantea otra pregunta: relacionar una imagen sintética con la real de la que procede.
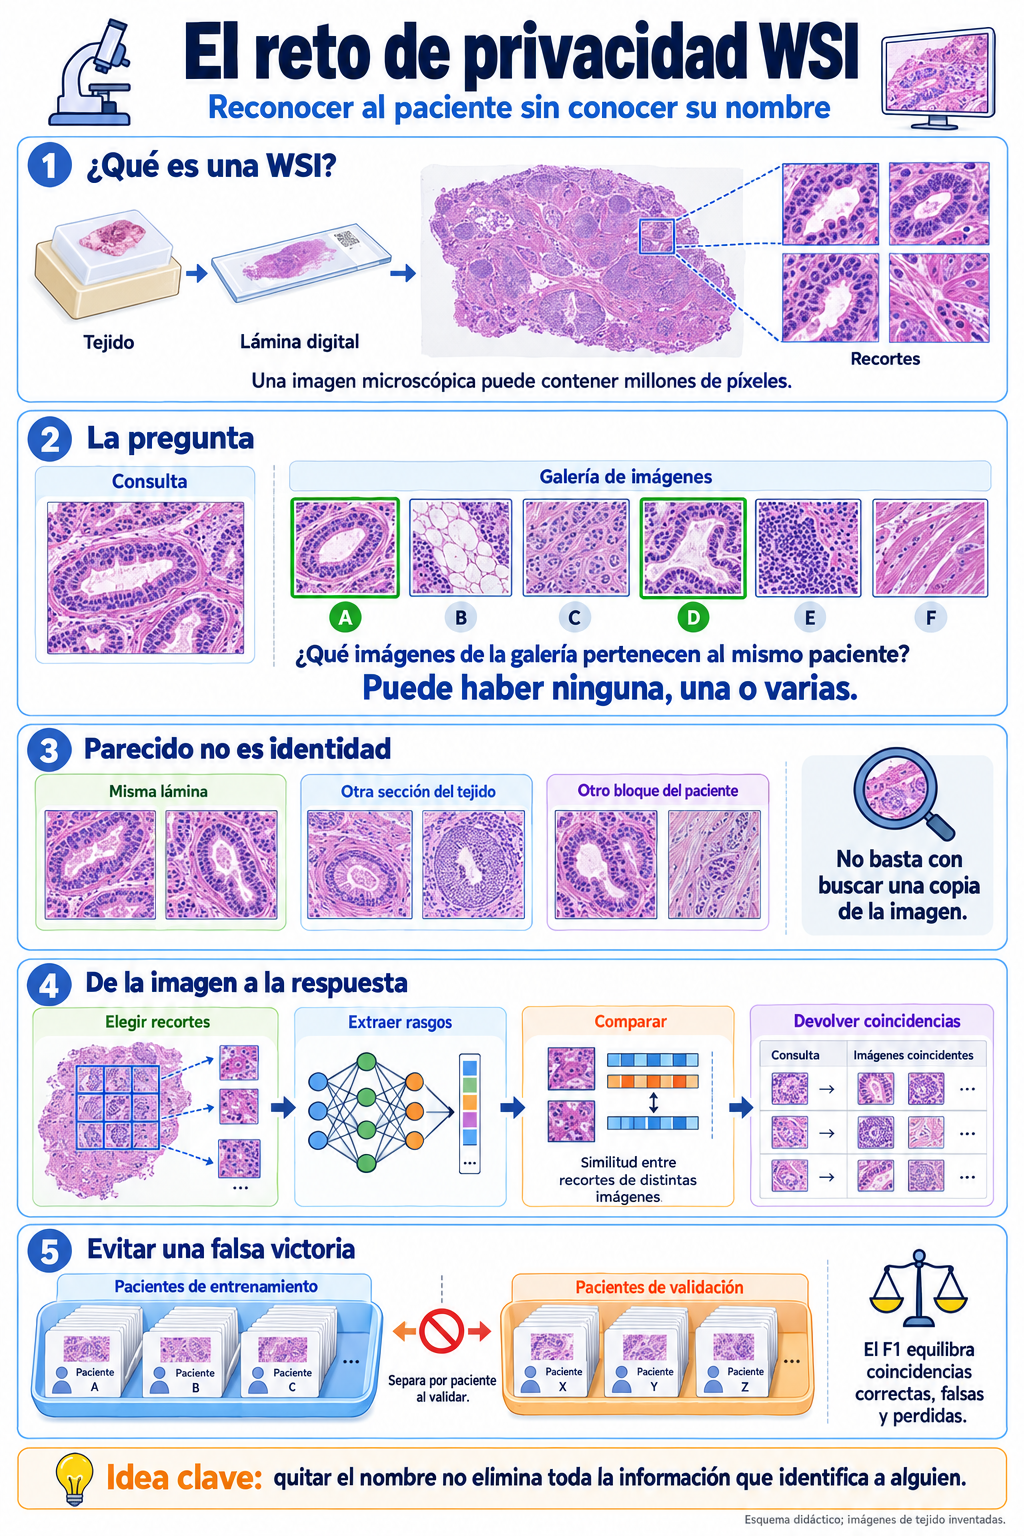
Las muestras de tejido son ilustraciones inventadas; no son imágenes de pacientes reales.
Ampliar y leer la infografía ↗El tejido se digitaliza en una lámina microscópica de gran tamaño. Para procesarla se seleccionan recortes.
Dada una imagen de consulta, hay que localizar las imágenes de la galería que procedan del mismo paciente. Puede no haber ninguna coincidencia, o puede haber una o varias. A y D representan las coincidencias del ejemplo dibujado.
No es lo mismo reencontrar la misma lámina que reconocer otra sección del tejido u otro bloque del paciente. El parecido visual por sí solo no demuestra identidad.
Seleccionar recortes, extraer rasgos, comparar y devolver coincidencias. Al validar, los pacientes de entrenamiento y validación deben estar separados. F1 tiene en cuenta aciertos, falsas coincidencias y omisiones. Quitar el nombre no elimina toda la información identificativa.
La ficha anuncia 10.000 ejercicios de entrenamiento y 5.000 de prueba, con bloques DORS/VEN y pacientes separados entre ambos grupos. Los códigos de paciente sirven para construir y corregir ejemplos, no como entrada para adivinar su solución.
Un ejercicio contiene una consulta y su galería. Puede reutilizar imágenes que aparecen en otro ejercicio. Por eso 10.000 ejercicios no equivalen a 10.000 personas. Dentro de una imagen podemos extraer muchos recortes; aumentan el trabajo de cálculo, pero no crean pacientes nuevos.
Una WSI es un escaneado de una preparación de tejido. Para procesarla leemos regiones y niveles de resolución. OpenSlide permite consultar dimensiones y, cuando están disponibles, micrómetros por píxel: el tamaño físico de lo que representa cada píxel. Un recorte de 224 × 224 píxeles puede mostrar cantidades de tejido diferentes según la escala.
Como ejemplo inventado, una imagen de 60.000 × 100.000 píxeles necesita 18 GB si se carga entera en RGB de 8 bits, sin compresión: seis mil millones de píxeles por tres bytes. El fichero comprimido puede ocupar bastante menos. Leer por regiones evita cargarlo todo de golpe.
Puede aportar varias muestras
Material físico del que sale la imagen
Archivo digital del escaneado
Regiones que recibe la red
Reconocer una copia exacta, dos escaneados de una preparación y tejidos distintos de una persona exige señales diferentes. Podemos acertar lo fácil y seguir fallando justo donde interesa investigar. Separar esos casos al analizar los errores evita que una buena media lo esconda.
El estudio previo de Holub y colaboradores compara ResNet, VGG16, Inception, Img2vec, SimCLRv2 y VGG16histo. Examina escáneres, proximidad entre cortes y recortes. Muestra que retirar el borde no elimina necesariamente la posibilidad de enlazar imágenes. Su métrica de riesgo Rs y su protocolo son distintos del F1 del concurso.
Hay código público del estudio y el artículo declara CSV experimentales y un cuaderno R. Son un punto de partida para estudiar métodos y resultados; no constituyen una solución ganadora de esta competición. No hemos ejecutado ese código ni recuperado el paquete de resultados para recalcular sus gráficas.
Una copia puede detectarse con comparaciones muy sencillas.
Cambian color, escala o aspecto del escaneado.
Parte de la estructura puede mantenerse entre secciones.
No basta con buscar el mismo dibujo desplazado.
Primero haría un inventario pequeño y abriría imágenes reales. Después reservaría pacientes para validar. Con eso prepararía una referencia sencilla: una ResNet50 preentrenada, sus pesos congelados y una comparación por similitud coseno. Congelados significa que no se modifican durante esta prueba.
La red convierte cada imagen en un vector, una lista de números que resume rasgos visuales. El coseno compara esos vectores. Esta primera versión ya permite producir respuestas y descubrir errores de preparación, aunque todavía no sea competitiva. Es un modelo de visión. Los agentes que ayudan a programar en ATLAS utilizan modelos de lenguaje, o LLM; en la historia ambos se apoyan en aprendizaje profundo, pero tienen funciones distintas.
En cada ejercicio hay cien candidatas. Empezaría comparándolas todas. Un buscador aproximado añade complejidad y puede omitir coincidencias: lo introduciría si medir el coste demuestra que hace falta. Guardaría los vectores para reutilizarlos cuando pruebe otra regla de decisión.
Una CNN aplica filtros aprendidos sobre zonas de la imagen. Un Vision Transformer, o ViT, relaciona fragmentos mediante atención. La arquitectura importa, pero también lo que aprendieron sus pesos y cómo preparamos la entrada. Compararía versiones concretas con el mismo reparto de pacientes.
UNI y Prov-GigaPath ofrecen representaciones preentrenadas en patología. Los consideraría frente a un modelo generalista, revisando condiciones de acceso, uso de pesos y reglas del concurso. Haber aprendido a reconocer patrones diagnósticos no garantiza conservar la mejor señal para vincular muestras.
Con varios recortes por imagen, otra decisión es cómo reunirlos. Promediar resulta sencillo; puede diluir un detalle relevante. Una agregación con atención aprende a dar distinto peso a las regiones, pero necesita datos y puede aprender atajos. La comparación debe demostrar qué aporta.
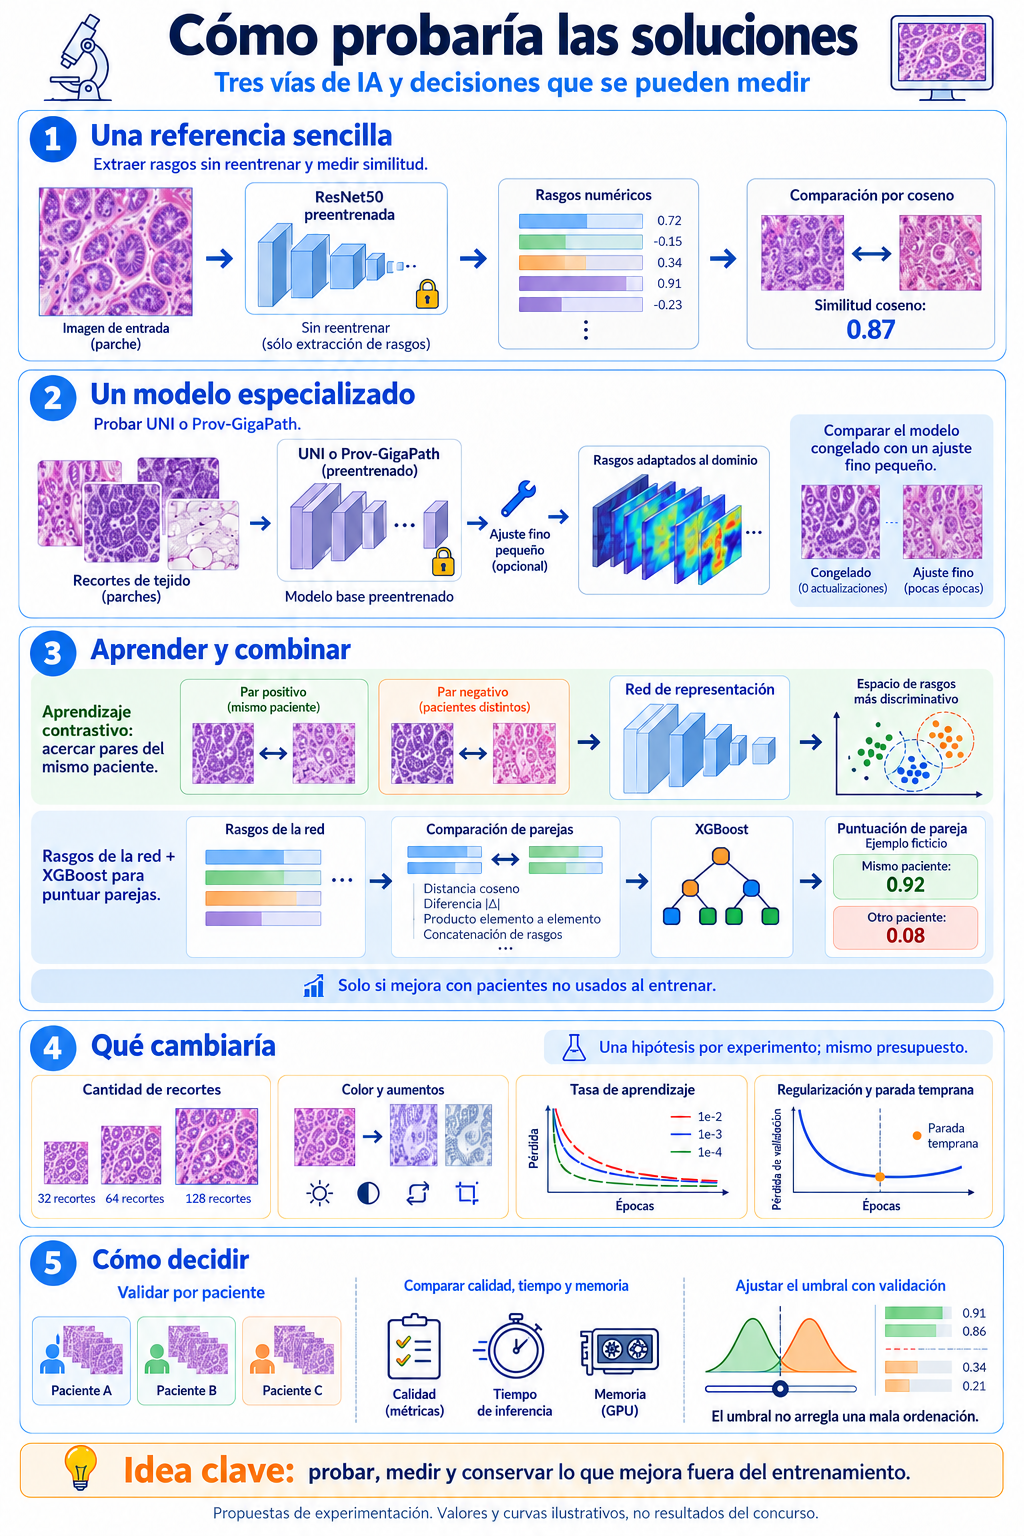
Son propuestas de experimentación. Las cifras, curvas y tejidos son ejemplos ilustrativos, no resultados del concurso.
Ampliar y leer la infografía ↗Empezaría extrayendo rasgos con ResNet50 preentrenada, sin reentrenarla, y comparando similitud coseno. Probaría después UNI o Prov-GigaPath, congelados y con un ajuste fino limitado.
El aprendizaje contrastivo utiliza pares del mismo paciente y de pacientes diferentes. Otra vía usa rasgos de la red y características de comparación —distancia coseno, diferencia absoluta o producto elemento a elemento— para que XGBoost puntúe parejas. Los valores dibujados son ficticios.
32, 64 o 128 son cantidades de recortes, no dimensiones. Compararía cambios de color y aumentos, tasa de aprendizaje, regularización y parada temprana con una hipótesis y un presupuesto común. Las curvas dibujadas no establecen qué tasa es mejor.
Validar por paciente, medir calidad, tiempo y memoria, y ajustar el umbral sobre validación. Un umbral no corrige una mala ordenación. Conservar solo lo que mejora con pacientes no usados para entrenar.
RUTA 1
Prueba económica: los pesos de la red se conservan.
RUTA 2
Cambia parte de los pesos para aprender el parecido que necesitamos.
RUTA 3
La red describe; un segundo modelo aprende a combinar las señales.
Aprender el parecido requiere ejemplos relacionados y ejemplos que se confundan sin estar relacionados. Una pérdida contrastiva penaliza las distancias equivocadas; una pérdida de tripletes compara una referencia, un positivo y un negativo. No entrenaría únicamente a reconocer una lista cerrada de pacientes: en la prueba aparecerán personas nuevas.
Tampoco obligaría a que dos recortes cualesquiera de una persona se parezcan. Pueden mostrar estructuras distintas. Si solo conozco la relación entre preparaciones completas, debo diseñar la supervisión a ese nivel o justificar cómo selecciono las parejas de regiones.
Esta tabla es un punto de partida razonado, no una receta óptima. Probaría pocas alternativas con presupuesto común, conservaría la mejor configuración de validación y ampliaría la búsqueda cuando los errores lo justifiquen.
| Decisión | Primeras alternativas propuestas | Qué observaría |
|---|---|---|
| Recortes y escala | 32, 64 o 128 regiones; misma escala física al comparar. | Si más detalle mejora los casos difíciles o solo alarga la ejecución. |
| Transformación | Giros y volteos; variación moderada de tinción, con/sin normalización. | Si la señal del origen se conserva o la transformación la borra. |
| Capas entrenables | Solo una cabeza pequeña; después los últimos bloques. | Si adaptar más parámetros ayuda o memoriza el conjunto. |
| Tasa de aprendizaje | Como ensayo: 0,00001 / 0,00003 en bloques; 0,0001 / 0,0003 en la cabeza. | Si el ajuste es estable. Los rangos dependen del modelo y del lote. |
| Lote y negativos | Varios pacientes y ejemplos por paciente; negativos difíciles bien etiquetados. | Si el modelo aprende a resolver confusiones reales, no solo parejas fáciles. |
| Regularización y parada | Penalización de pesos; paciencia de parada, por ejemplo 3 o 5 evaluaciones. | Validación frente a entrenamiento; recuperar el mejor estado, no el último. |
Sí, tiene sentido probarlo. La red extrae representaciones y construimos una fila por pareja: su similitud global, distancias entre vectores, estadísticas de coincidencias locales y señales de calidad de la imagen. Una regresión logística ofrece una referencia sencilla; XGBoost permite aprender combinaciones no lineales.
Por ejemplo, una similitud global alta podría no bastar si las regiones más informativas discrepan. El combinador puede aprender a usar ambas señales. Variaría profundidad de árboles, tasa de aprendizaje y regularización. No le entregaría miles de millones de píxeles ni el código de paciente que contiene la respuesta.
También podemos mezclar puntuaciones de dos redes. Miraría primero sus errores: si se equivocan en las mismas consultas, quizá paguemos el doble por casi lo mismo. Para entrenar la mezcla usaría predicciones de pacientes que el modelo base no haya visto durante su ajuste, con sus escalas de puntuación compatibles.
El umbral decide a partir de qué puntuación aceptamos una coincidencia. Bajar el mínimo puede recuperar una verdadera y colar otra falsa. Subirlo puede limpiar la respuesta y dejar fuera algo que debíamos encontrar. No modifica los pesos de la red.
En este ejemplo inventado hay seis candidatas, para que puedas seguir las cuentas. A y C son las coincidencias reales. Las puntuaciones son similitudes ilustrativas, no probabilidades. Mueve el control y observa qué entra en la respuesta. También puedes probar una consulta sin coincidencias.
Con estas puntuaciones, B es falsa y puntúa más que C, que es verdadera. Ningún umbral puede aceptar C y rechazar B. Para resolver ese error necesitamos mejores señales o un modelo que las combine de otra manera.
Precisión cuenta qué proporción de lo que proponemos es correcto. Exhaustividad cuenta qué proporción de lo que debíamos encontrar hemos recuperado. F1 combina ambas: 2 × aciertos / (2 × aciertos + falsas coincidencias + omisiones). Para este ejercicio, acertar una respuesta vacía da 1; introducir una coincidencia falsa en ella da 0.
PRUEBA INTERACTIVA · DATOS INVENTADOS
Entran las candidatas cuya puntuación es igual o mayor que el umbral. Sin JavaScript se muestra el ejemplo inicial: umbral 0,65 y respuesta A, B, C.
Respuesta: A, B, C
2 aciertos · 1 falsa coincidencia · 0 omisiones
Hemos encontrado A y C, pero también hemos incluido B.
Una galería reducida para entender la cuenta. Estas cifras no son resultados del concurso. Cuando precisión o exhaustividad no tienen denominador, se muestran como «no definida»; F1 usa la convención del caso vacío explicada arriba.
Separaría pacientes antes de sacar recortes o formar parejas. Si fragmentos de una misma persona aparecen a ambos lados, el programa puede reconocer material conocido y darnos una impresión exagerada de su capacidad. Las transformaciones que aprenden estadísticas también se ajustan solo con el grupo de entrenamiento.
Compararía las variantes en las mismas consultas, con un presupuesto parecido. Además de la media de F1, revisaría precisión, exhaustividad, falsas coincidencias cuando no hay ninguna real, tipo de relación entre muestras, tiempo y memoria. Varias consultas pueden reutilizar imágenes: para estimar la incertidumbre hay que respetar los grupos de pacientes.
La validación nos ayuda a elegir y deja de ser independiente de esa elección. Reservaría una comprobación final interna o un protocolo por grupos que distinga ajuste y evaluación. No elegiría el umbral después de mirar las respuestas del examen final. Guardar un ensayo fallido también tiene utilidad: evita gastar otra noche en la misma idea.
En este reto el archivo de respuestas relaciona cada consulta con sus coincidencias. Obtener esa tabla exige una cadena: leer imágenes, preparar regiones, calcular representaciones, combinar señales y aplicar la decisión final. Ese proceso completo es el pipeline.
Guardaría código, versiones, preparación, pesos, reparto de pacientes y umbral para reconstruir la tabla. Eso no implica que el organizador pida todos esos componentes al enviar. Las reglas de otros concursos pueden exigir código o un modelo ejecutable: hay que comprobar cada caso.
Antes del envío comprobaría que cada identificador pertenece a su galería, que no faltan consultas y que el caso vacío se interpreta correctamente. La descripción oficial alterna NONE y un campo vacío; consultaría la plantilla vigente y aclararía esa ambigüedad antes de competir.
Los premios pueden ser una razón, pero el balance también incluye horas, máquinas y oportunidades. Una empresa puede pagar por aprender a preparar imágenes, adaptar un modelo o mantener un servicio reproducible. La comparación abierta sirve para medir capacidades y descubrir gente con la que trabajar. Ese retorno necesita un objetivo y un presupuesto; participar por participar no lo garantiza.
En el cómic, Nexo busca investigación aplicada y cantera. Esa es una decisión de la ficción, no una promesa de Kaggle. Financiar a dos equipos tampoco convierte un concurso abierto en un duelo entre ambos. Y un buen resultado no hace automáticamente utilizables los datos o pesos en otro negocio.
Para controlar el coste mediría primero un lote pequeño: lectura de disco, extracción de recortes, cálculo de vectores y comparación. Guardar vectores ayuda a probar umbrales o combinadores sin repetir la red; cambiar la red o su preparación puede invalidar esa caché. En ATLAS, las consultas del agente pasan por una API y el texto enviado y recibido se mide en tokens. Su cupo pertenece al servicio de lenguaje, cuyo cálculo aporta el proveedor. El tiempo y la memoria de la GPU compartida y la disponibilidad de quien revisa siguen siendo otras cuentas.
Preparar datos, ajustar modelos, medir errores y organizar entregas.
Permisos, población nueva, calidad y coste del uso concreto.
El puesto final, los ingresos y que el método funcione fuera del reto.
Fuentes revisadas el 27 de octubre de 2026. El calendario publicado anuncia cierre el 31 de octubre y resultados en noviembre. No presentamos una clasificación final ni una receta ganadora.
La ficha de Kaggle permite conocer el encargo; el artículo y su repositorio permiten estudiar el antecedente; los repositorios de modelos sirven para diseñar comparaciones. Son materiales con funciones distintas. Las pestañas de datos, código y clasificación no devolvieron contenido utilizable durante esta consulta: eso no demuestra que estén vacías.
Si quieres recorrer la guía con un ejercicio propio, empieza por un conjunto permitido y pequeño, establece una referencia y anota qué hipótesis cambia en cada prueba. Una tabla con modelo, preparación, parámetros, puntuación de validación, tiempo y errores observados aporta más que una lista de redes que nunca hemos comparado.